Station の音声入力はシステム全体で動作します。キーを押している間だけ録音し、音声を自分の CPU または選んだプロバイダーでテキストにし、編集者のように整えて、開始時にフォーカスのあったフィールドに貼り付けます。Enter は決して押しません。
- 0.9 s
- ローカルモデルで 6.8 秒の音声を文字起こしする時間(Ryzen 7 5700X)
- 0 ms
- キーリスナーのアイドル時 CPU 負荷: キーボードフックではありません
- 2 min
- 1 回の録音の長さ。ハンズフリーでも押しっぱなしでも
1/4 · Ctrl+Win を2回押す
続けて2回押すと、どのアプリでもハンズフリーになります。画面下のピルが、聞いていることを示します。
Station で収録、サンプルプロジェクト · 待ち時間は早送り
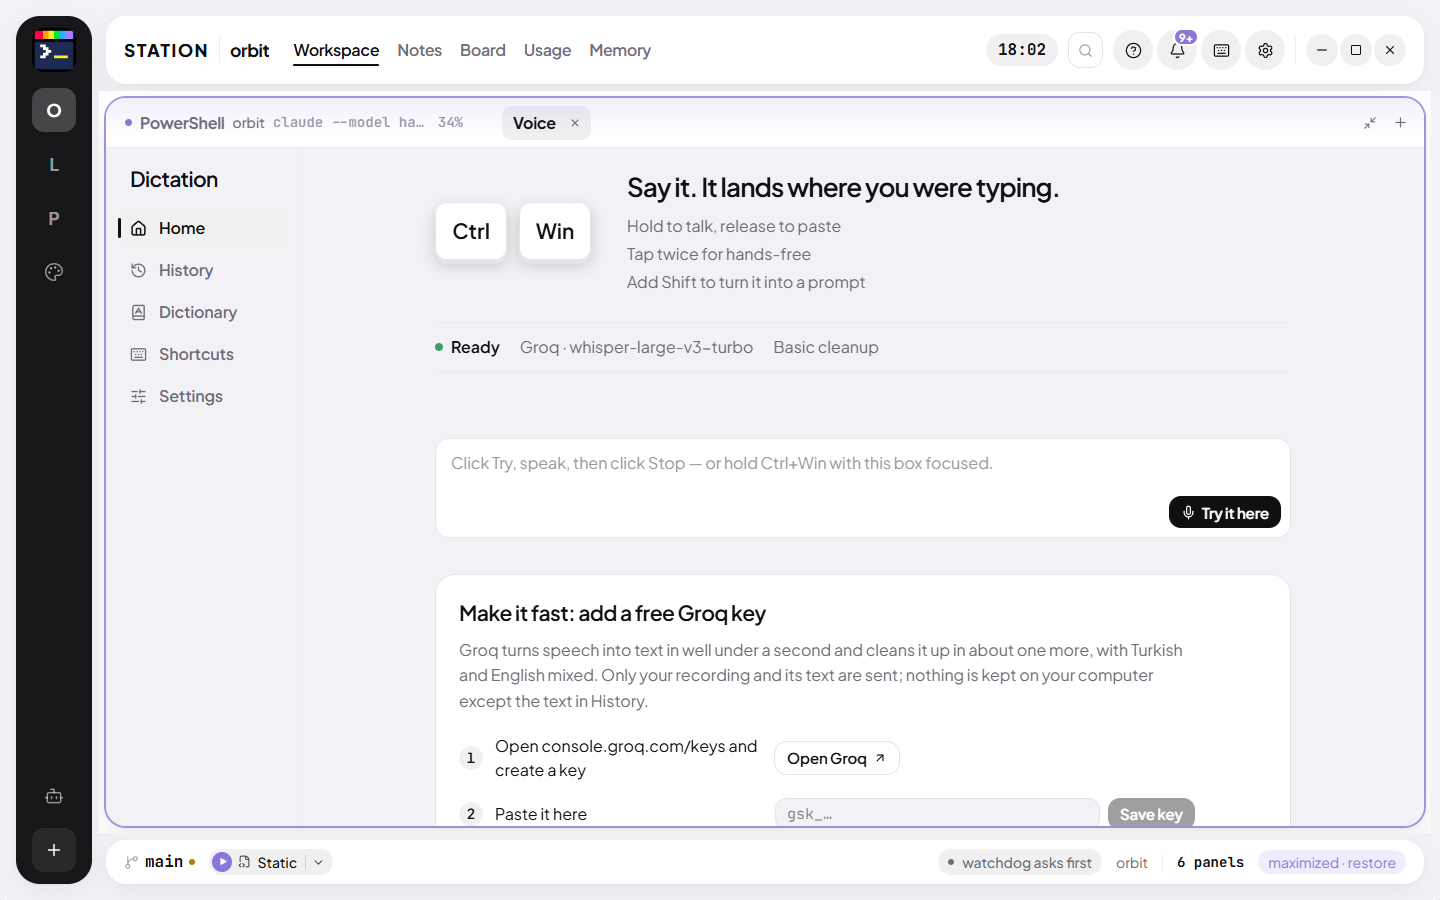
3 つの操作
Ctrl+Win をしばらく押したまま話し、離すと終了します。2 回タップするとハンズフリーで話せて、もう一度タップすると止まります。話している間 Shift を押していると、文章ではなく構造化されたプロンプトになります。Esc で録音を破棄します。マイクは押した瞬間に開くので、最初の一音も逃しません。
- Station 内では、キャレットのあるフィールドまたはターミナルにテキストが入ります
- それ以外のアプリでは、クリップボード経由で貼り付けます
- 浮かぶピルが状態(音声入力、文字起こし中…、整形中…、貼り付け完了)をライブ波形つきで示します
音声からテキストへ、3 つの方法
ローカルは CPU 上で whisper.cpp を動かし、初回利用時にダウンロードします。8 MB のエンジンと 181 MB のモデルで、6.8 秒の音声を 0.9 秒で文字起こしします。難しい音声には 547 MB の大型モデルもあります。アカウントもキーもネットワークも不要です。ホスト型は OpenAI 互換 API を使います。Groq の whisper-large-v3-turbo、OpenAI の gpt-4o-transcribe、または指定した任意のベース URL とモデルです。
あなたの言葉を書き換えない整形
2 段階目では、リストではなく働きでフィラー(「えーと」「あの」「like」「you know」など)を取り除き、言い直し(「あ、違う、typecheck を」)は残し、句読点を補い、認識が誤った技術用語を文脈から直します。要約も翻訳も回答もしません。話した内容は常にテキストとして扱われ、指示として扱われることはありません。プロバイダーのキーがない場合は、代わりに高速なルールベースの整形が動きます。
- 認識と整形の両方をプロジェクト固有の語に誘導する語彙リスト
- 置換:「X と聞こえたら Y と書く」
- 無音や、Whisper が作りがちな字幕クレジットの幻覚に対するガード
設計からプライベート
音声がディスクに書き込まれることはありません。履歴に残るのはテキストと話す速度で、スイッチ 1 つでオフにできます。キーリスナーは、Windows に最初から入っている C# コンパイラであなたのマシン上でコンパイルされる 9 KB のヘルパーです。設定したキーだけを 10 ms ごとに確認し、メモリ使用量は 12 MB です。
2 日間、全機能、カード不要。